Le maillon faible n'est pas celui qu'on croit
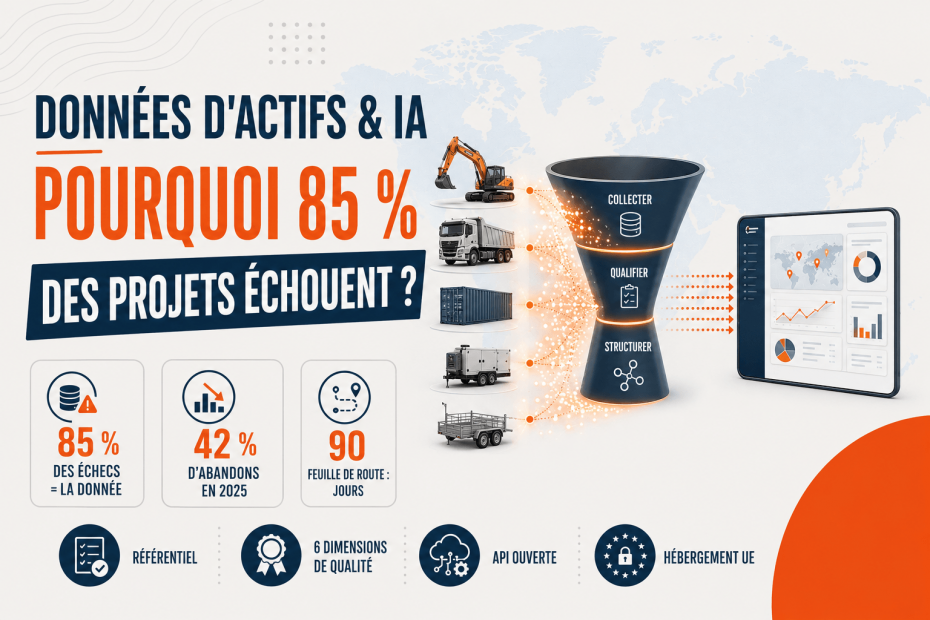
Environ 85 % des projets d'IA échouent à cause de la donnée, pas du modèle, selon Gartner. Pour un parc d'actifs géolocalisés, la réussite d'un projet données et IA repose sur quatre fondations : un référentiel d'actifs propre avec identifiant unique, six dimensions de qualité mesurées en continu, une gouvernance RGPD et souveraineté, et une architecture qui expose la donnée par API. La méthode tient en une feuille de route de 90 jours : cadrer, fiabiliser, exploiter.
Équiper 300 engins de traceurs crée un gisement de données. Mais tant que cette donnée n'est pas structurée, identifiée et gouvernée, elle reste un point sur une carte : exacte mais muette. Les directions qui veulent « faire de l'IA sur le parc » butent presque toutes sur le même mur, et ce mur n'est pas algorithmique. Cet article explique ce qu'est une donnée d'actif prête pour l'IA et déroule la méthode pour y arriver.
Pourquoi 85 % des projets IA échouent-ils ?
Réponse directe : parce que le maillon faible n'est presque jamais le modèle mais la donnée d'entrée : selon Gartner, environ 85 % des échecs de projets IA tiennent à sa qualité, et la RAND Corporation estime que plus de 80 % des projets IA n'atteignent jamais la production.
Les chiffres publiés en 2025 dessinent un paysage sévère : au-delà des estimations de Gartner et de la RAND, l'IBM Institute for Business Value (2025) chiffre le coût de l'inaction : décisions prises sur un taux d'utilisation faux, surparc maintenu, alertes ignorées, maintenance qui ne prédit rien.
La donnée d'un parc d'actifs cumule trois particularités que la gestion de données classique couvre mal : elle est temporelle (l'instant et l'ordre comptent), spatiale (rapportée à des zones) et massive et continue. Investir dans la donnée avant l'algorithme inverse le ratio d'échec : c'est la thèse du guide TRAKmy, et celle des organisations qui réussissent, deux fois plus nombreuses à avoir repensé leurs processus avant de choisir leurs outils selon McKinsey (2025).
Qu'est-ce qu'une donnée d'actif « prête pour l'IA » ?
Réponse directe : une donnée AI-ready n'est ni la plus volumineuse ni la plus récente : c'est celle qu'un modèle ou un tableau de bord peut exploiter sans retraitement manuel. Cinq propriétés la définissent : alignée sur un cas d'usage, gouvernée au niveau de l'actif, alimentée par des flux contrôlés, décrite par des métadonnées vivantes, et vérifiée en continu.
✅ Le test le plus simple : « si je donnais ce fichier à un analyste qui ne connaît pas mon parc, pourrait-il l'exploiter sans me poser de questions ? ». Si la réponse est non, la donnée n'est pas prête, et un modèle sera moins indulgent encore qu'un analyste.
Trois états de maturité se succèdent : la donnée brute (la trame qui sort du traceur, exacte mais muette), la donnée structurée (rattachée à un actif nommé, une zone, un temps normalisé) et la donnée enrichie, croisée avec les sources métier, comptabilité, planning, maintenance. C'est dans ce troisième état que naît la valeur.
Cette exigence rejoint les trois défis techniques historiques du suivi d'actifs, couverture, autonomie, fiabilité, que nous détaillons dans les trois challenges techniques de l'asset tracking : une donnée fiable commence par un matériel et un réseau fiables.
Qu'est-ce qu'un référentiel d'actifs et pourquoi est-il décisif ?
Réponse directe : le référentiel d'actifs est la table de vérité qui donne à chaque actif un identifiant unique et immuable, une catégorie issue d'une liste fermée, une valeur, une date de mise en service et une affectation. Son absence est la première cause d'échec des projets de données de parc.
La quasi-totalité des projets butent sur ce socle négligé : la donnée existe, mais elle n'est rattachée à rien. L'identifiant pivot ne doit jamais changer, même si l'actif est réaffecté ou rééquipé : le traceur change, la table de correspondance se met à jour, l'historique reste intact. La taxonomie doit être fermée : « pelle », « pelleteuse » et « mini-pelle » en texte libre désignent le même engin sans qu'aucun traitement puisse les regrouper.
⚠️ Signal d'alerte : un référentiel qui vit dans un tableur partagé, mis à jour à la main sans règle, est non fiable par défaut. Un référentiel sérieux a un propriétaire désigné, des règles de saisie, un historique et une source de vérité unique.
Ce chantier, peu spectaculaire, conditionne tout le reste : agrégations par famille, calcul du ROI par la valeur d'acquisition, détection des écarts entre affectation théorique et position réelle. Notre article optimisation de la gestion des stocks par traceur GPS montre ce que débloque un référentiel propre.

Préparer ses données d'actifs pour l'IA
Quelles sont les six dimensions de la qualité de données ?
Réponse directe : complétude, exactitude, cohérence, fraîcheur, unicité et traçabilité. Une seule dimension défaillante suffit à fausser un modèle : l'IA propage les erreurs au lieu de les corriger, et les dimensions faibles ne se compensent pas entre elles.
| Dimension | Ce qu'elle mesure | Comment la contrôler |
|---|---|---|
| Complétude | Part des données attendues réellement présentes | Pourcentage par actif et par période, seuil de suspicion |
| Exactitude | Écart entre la donnée et la réalité | Règles de plausibilité, recoupement, échantillon terrain |
| Cohérence | Absence de contradictions entre sources | Croisements, sémantique et unités stables |
| Fraîcheur | Délai entre production et disponibilité | Cadence adaptée au besoin, pas la plus fréquente possible |
| Unicité | Aucun doublon d'actif ou d'événement | Identifiant pivot, déduplication, horodatage |
| Traçabilité | Origine et transformations connues | Métadonnées de lignage tout au long du pipeline |
Deux réflexes de télémétrie complètent ces contrôles. D'abord, normaliser le temps : tout en référence unique, UTC stocké, affichage local, car une série au temps faux est inexploitable. Puis, marquer les trous plutôt que les masquer : une donnée interpolée non signalée est pire qu'un trou, le trou dit « je ne sais pas » quand l'interpolation masquée affirme une fausseté. Un bon traceur stocke ses positions hors ligne en zone blanche et les remonte au retour du signal : le trou définitif devient un trou comblé en différé.
Par quel cas d'usage IA commencer sur un parc d'actifs ?
Réponse directe : commencez par le surparc (10 à 15 % d'économies, peu exigeant en historique), puis la détection d'anomalies et de vols, avant la maintenance prédictive (30 à 50 % d'immobilisations en moins, ROI documenté autour de 10 pour 1) qui exige un historique propre. Commencer par le cas le plus exigeant est la première cause d'échec.
L'ordre compte parce que chaque étape finance et alimente la suivante : la chasse au surparc dégage des gains rapides avec une simple mesure d'utilisation ; la détection d'anomalies exige peu d'historique et accélère les récupérations ; ces deux étapes accumulent la donnée propre dont la maintenance prédictive a besoin, avant le pilotage prédictif des investissements qui mobilise toutes les dimensions de qualité. Les gains types sont documentés par les études techniques 2025-2026, dont celles du département américain de l'Énergie sur la maintenance conditionnelle.
Côté architecture, la valeur se joue à l'exposition : une API ouverte, documentée et bidirectionnelle est le critère technique le plus déterminant, sans laquelle la donnée reste prisonnière de la plateforme. Le MQTT et les webhooks poussent les événements temps réel vers l'ERP, le TMS ou la GMAO, et l'export Power BI alimente le décisionnel : c'est l'équipement natif des plans Professional et Analytics de la plateforme TRAKmy, avec des capteurs comme ceux de l'ULTRA N+ (température, chocs, orientation, activité, arrachage) qui produisent les séries d'usage de la maintenance prédictive. La gouvernance referme le dispositif : finalité documentée, personnes informées dès qu'un véhicule conduit par un salarié est suivi, durées de conservation définies et hébergement des données en Union européenne. Notre panorama IoT, IA et géolocalisation dans la supply chain et le guide RGPD géolocalisation complètent ces deux volets.

Questions fréquentes
Réponse directe : quatre questions structurent les projets : le délai pour être AI-ready, la stratégie de nettoyage, les pièges récurrents et la bonne fréquence de remontée.
Combien de temps faut-il pour rendre un parc AI-ready ?
Faut-il tout nettoyer avant d'exploiter quoi que ce soit ?
Quels sont les pièges les plus fréquents ?
La fréquence de remontée la plus élevée est-elle la meilleure ?
Faisons de votre parc une source de données fiable
Matériel fiable à la source, stockage hors ligne, API, MQTT et export Power BI, données hébergées en Europe : TRAKmy fournit la chaîne AI-ready de bout en bout.
TRAKmy arrive en Espagne : traceurs GPS via trakmy.es
TRAKmy lance son offre de traceurs GPS en Espagne avec...
Lire l'article →
COMPACT 1115 : traceur GPS compact NB-IoT et LTE-M | TRAKmy
Le COMPACT 1115 : traceur GPS compact 105 × 54...
Lire l'article →
Cahier des charges géolocalisation : la méthode pour choisir
Cadrage du besoin, 10 blocs de critères pondérés, questions aux...
Lire l'article →
Business case géolocalisation : convaincre sa direction
Coût du statu quo, TCO 5 ans, ROI, payback, VAN,...
Lire l'article →
Données d’actifs et IA : pourquoi 85 % des projets échouent
85 % des projets IA échouent à cause de la...
Lire l'article →
Baromètre 2026 : la géolocalisation d’actifs en France
Vols d'engins doublés, maturité par secteur, bascule post-2G, ROI en...
Lire l'article →